En bref
Une demande envoyée à un assistant d’IA part sur les serveurs de son éditeur, avec ses fichiers joints. Selon l’offre, elle y est conservée, parfois relue par des personnes, et elle peut servir à entraîner les modèles. Chez OpenAI, Anthropic, Google, Microsoft et Mistral, les conversations des comptes personnels, gratuits ou payants, peuvent servir à l’entraînement, selon un réglage ; les offres pour les entreprises relèvent de conditions commerciales, avec un contrat ; pour les API, chaque éditeur a sa règle. Le RGPD demande un contrat de sous-traitance et un cadre pour les transferts hors de l’Union ; la CNIL recommande une charte interne et des équipes formées ; le règlement européen sur l’IA demande aux entreprises qui s’en servent de soutenir la maîtrise de l’IA de leur personnel. Pour l’équipe, une règle en trois couleurs suffit à commencer : vert, orange, rouge.
Ce qu’une équipe tape dans un assistant d’IA part chez son éditeur, et la suite dépend de l’offre et des réglages. Voici ce qu’en disent les éditeurs, la CNIL, le RGPD et le règlement européen sur l’IA, puis une règle en trois couleurs et une liste à cocher avant d’adopter un outil.
Les assistants d’IA entrent souvent dans les équipes par la petite porte : un compte ouvert un soir, un document collé pour gagner une heure. La question des données vient ensuite. Cette note la prend dans l’ordre : ce que devient une demande, ce que disent les éditeurs, ce que demandent les textes, puis une règle que toute l’équipe peut retenir. Les usages eux-mêmes, et le temps qu’ils font gagner, ont leur note : Quand l’IA fait gagner du temps, et quand elle en fait perdre.
Ce que devient une demande envoyée à une IA
Une demande tapée dans un assistant d’IA quitte le poste de travail : le texte et chaque fichier joint partent sur les serveurs de l’éditeur, qui calcule la réponse et la renvoie. La suite tient en quatre questions : dans quel pays la demande est traitée, combien de temps elle est gardée, qui peut la lire, et si elle sert à entraîner les modèles. Les réponses changent d’une offre à l’autre, chez un même éditeur.
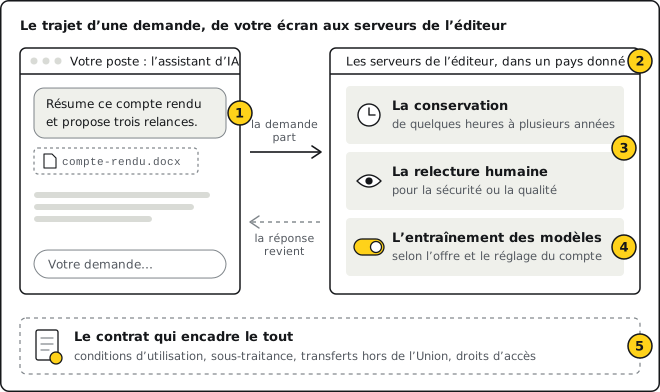
- Ce qui entre : le texte de la demande et ses fichiers joints
- Le pays des serveurs, et les transferts hors de l’Union
- La conservation et la relecture, chez l’éditeur
- L’entraînement, selon l’offre et le réglage du compte
- Le contrat qui encadre le tout
L’entraînement inquiète le plus, et à raison : une conversation qui y sert devient une matière première de l’éditeur. Les trois autres questions comptent autant. Un historique gardé des années reste consultable des années ; une relecture humaine place une personne devant le texte ; un traitement hors de l’Union appelle un cadre juridique, que la section 3 détaille.
Ce que disent les éditeurs, offre par offre
Nous avons relu, le 1er novembre 2026, la documentation publique de cinq éditeurs. Elle trace partout la même frontière : d’un côté les comptes personnels, gratuits ou payants ; de l’autre les offres pour les entreprises et les API, régies par des conditions commerciales.
| Éditeur | Comptes gratuits ou personnels | Offres pour les entreprises | API |
|---|---|---|---|
| OpenAI (ChatGPT) | Free, Plus et Pro : le contenu peut servir à entraîner les modèles ; un réglage des contrôles de données s’y oppose. Une discussion temporaire reste hors de l’entraînement et s’efface après 30 jours. | Business, Enterprise et Edu : entrées et réponses restent hors de l’entraînement par défaut. | Hors de l’entraînement depuis le 1er mars 2023, sauf accord du client ; journaux de surveillance des abus gardés jusqu’à 30 jours. |
| Anthropic (Claude) | Free, Pro et Max : depuis l’annonce du 28 août 2025, chacun choisit si ses conversations servent à l’entraînement. En cas d’accord, elles sont gardées cinq ans ; sinon, trente jours. | Team et Enterprise relèvent des conditions commerciales : conversations hors de l’entraînement par défaut. | Même règle que les offres pour les entreprises. |
| Google (Gemini) | Avec « Conserver l’activité », les conversations peuvent servir à améliorer les modèles ; une part est lue par des relecteurs et gardée jusqu’à trois ans. Réglage désactivé : 72 heures dans le compte. | Gemini dans Google Workspace : les requêtes sont des données client, hors de l’entraînement sauf autorisation, et hors de la relecture humaine. | Services gratuits : contenus utilisés pour améliorer les produits. Services payants : hors de cet usage. Dans l’Espace économique européen, les règles des services payants valent pour tous. |
| Microsoft (Copilot) | Compte Microsoft personnel : les conversations peuvent servir à l’entraînement ; un réglage les en exclut. | Compte professionnel : invites, réponses et données de Microsoft 365 restent hors de l’entraînement des modèles de fondation ; Copilot montre à chacun ce qu’il peut déjà ouvrir. | Modèles vendus par Azure dans Foundry : hors de l’entraînement sauf autorisation, traités dans la zone géographique choisie par le client, selon le type de déploiement. |
| Mistral (Vibe, ex-Le Chat) | Comptes individuels : entrées et réponses servent par défaut à l’entraînement ; un réglage s’y oppose à tout moment. | Team : l’administrateur coupe l’entraînement pour toute l’organisation. Enterprise : hors de l’entraînement par défaut. | Un réglage de la console coupe l’usage des appels pour améliorer les services ; il se règle à part de celui de Vibe. |
« Avec un abonnement payant, nos données sont à l’abri. »
Ce qui compte est le type d’offre. Les abonnements individuels payants, comme ChatGPT Plus ou Pro, Claude Pro ou Max, suivent les règles des comptes personnels : leurs conversations peuvent servir à l’entraînement, selon le réglage. Les offres pour les entreprises et les API relèvent de conditions commerciales, avec un contrat et une console d’administration.
Le réglage de l’entraînement couvre l’entraînement, et lui seul. La conversation part quand même sur les serveurs de l’éditeur et y reste un temps : 72 heures dans l’application Gemini quand l’activité est désactivée, 30 jours pour une discussion temporaire de ChatGPT. Un avis donné sur une réponse, le pouce levé ou baissé, peut aussi transmettre la conversation entière pour améliorer les modèles : OpenAI, Anthropic et Mistral le précisent. Google invite d’ailleurs les utilisateurs de l’application Gemini à garder pour eux les informations confidentielles, puisqu’un relecteur peut les lire.
Ce que demandent le RGPD et la CNIL
Le RGPD s’applique dès qu’une demande contient une donnée personnelle : toute information qui se rapporte à une personne identifiée ou identifiable. Le nom d’un client, une adresse électronique, un CV, le compte rendu d’un entretien annuel en font partie. Remplacer un nom par une initiale garde la donnée dans le champ du règlement : selon son considérant 26, une donnée pseudonymisée, qu’une information complémentaire permet de rattacher à une personne, reste une donnée personnelle.
Une entreprise qui confie des données personnelles à un outil d’IA en est responsable de traitement, comme le rappelle la fiche de France Num sur les précautions d’usage de l’IA générative, conçue avec la CPME et la CNIL. Le fournisseur de l’outil prend alors, le plus souvent, le rôle de sous-traitant.
Sous-traitantnom masculin, au sens du RGPD
L’organisme qui traite des données personnelles pour le compte d’un autre, le responsable de traitement, et sur ses instructions. L’éditeur d’une offre pour les entreprises ou d’une API l’est en général pour les données que vous lui confiez, et l’article 28 du RGPD exige alors un contrat entre vous, souvent appelé DPA, de l’anglais Data Processing Agreement. Avec un compte personnel, ce sont les conditions grand public et la politique de confidentialité de l’éditeur qui s’appliquent.
Voir aussi la liste à cocher, avant d’adopter un outil.
Trois obligations du RGPD prennent ici un relief particulier.
Le contrat. L’article 28 demande de choisir un sous-traitant qui protège les données de façon suffisante, et de signer un contrat qui encadre le traitement. Les offres pour les entreprises l’apportent avec leur avenant sur le traitement des données : Google parle de son avenant relatif au traitement des données dans le cloud, Microsoft de son addendum sur la protection des données.
Les transferts. Une donnée traitée hors de l’Union européenne demande un cadre : une décision d’adéquation de la Commission européenne, des clauses contractuelles types, ou un autre outil prévu par le RGPD, que la CNIL détaille. Pour les États-Unis, la décision du 10 juillet 2023 couvre les seules entreprises inscrites au cadre de protection des données, dont le ministère américain du commerce publie la liste. Le Tribunal de l’Union européenne l’a confirmée le 3 septembre 2025 ; un pourvoi est en cours devant la Cour de justice. Plusieurs éditeurs proposent aussi un traitement en Europe : Microsoft avec la limite des données de l’Union pour Copilot, OpenAI pour l’API, sur demande et sous conditions.
L’information des personnes. Les clients, les candidats ou les salariés dont les données passent par l’outil en sont informés, dans la politique de confidentialité ou la notice qui leur est remise, avec les destinataires de leurs données.
La CNIL a publié en juillet 2024 ses questions-réponses sur l’utilisation d’un système d’IA générative. Elles tracent une méthode. Partir de besoins concrets. Pour des données personnelles ou sensibles, préférer un déploiement sur site, installé chez soi. Avec un service en ligne, éviter autant que possible la saisie de données personnelles, et s’opposer à la réutilisation des données par le fournisseur. Encadrer l’usage par une charte interne qui liste les usages autorisés et les usages interdits. Former les utilisateurs, vérifier les réponses avant de s’en servir, associer le délégué à la protection des données, et mener une analyse d’impact quand le traitement le demande. Pour les services grand public, la CNIL demande de garder pour soi les informations confidentielles, données personnelles comprises.
L’ANSSI va dans le même sens : son guide de sécurité sur l’IA générative recommande de proscrire les outils d’IA générative ouverts sur Internet pour un usage professionnel qui touche des données sensibles.
Ce que prévoit le règlement européen sur l’IA
Le règlement (UE) 2024/1689, entré en vigueur le 1er août 2024, appelle « déployeur » l’organisme qui utilise un système d’IA dans son activité : une entreprise qui équipe ses équipes d’un assistant l’est. Notre note sur l’IA en entreprise détaille ce qu’il lui demande, d’après la Commission européenne ; trois points comptent ici.
La maîtrise de l’IA. Depuis le 2 février 2025, l’entreprise prend des mesures pour que son personnel maîtrise les outils qu’il utilise. L’omnibus numérique, entré en vigueur le 27 juillet 2026, en a assoupli la formule et laisse la forme au choix de chacun ; les autorités nationales contrôlent ce point depuis le 2 août 2026. L’exemple de la Commission parle à toutes les PME : une entreprise dont les salariés rédigent des textes publicitaires avec un assistant les informe de ses risques. Une règle écrite sur les données, comme celle des trois couleurs, peut en faire partie.
La transparence. Depuis août 2026, une personne qui échange avec un agent conversationnel en est informée ; les hypertrucages, et certains textes publiés pour informer le public sur des sujets d’intérêt général, portent la mention de leur origine.
Les systèmes à haut risque. Leurs obligations, qui touchent par exemple le recrutement, s’appliqueront le 2 décembre 2027.
Le règlement sur l’IA s’ajoute au RGPD. La fiche de France Num le résume : les deux textes reposent sur les mêmes principes, dont le contrôle humain, la transparence et la gouvernance des données. Cette note décrit les textes ; pour un cas précis, votre délégué à la protection des données ou votre juriste tranche.
Le secret des affaires et les contrats clients
Une bonne part des données sensibles d’une entreprise concerne ses affaires plutôt que des personnes : un prix de revient, une marge par client, une formule, une offre en préparation, le code d’un logiciel maison. Le Code de commerce les protège au titre du secret des affaires, à trois conditions cumulées, fixées par l’article L151-1. L’information échappe à la connaissance courante des gens du secteur ; elle a une valeur commerciale du fait de son secret ; son détenteur la protège par des mesures raisonnables.
La troisième condition se prouve : il revient au détenteur de montrer les mesures prises. Une règle écrite sur ce qui entre dans les outils d’IA, et des comptes réglés pour exclure la réutilisation, en font partie. Un secret collé dans un compte personnel, à l’inverse, peut affaiblir cette démonstration.
Les secrets des clients, eux, obéissent aux contrats. Un accord de confidentialité désigne le plus souvent les personnes autorisées à recevoir l’information, et parfois les sous-traitants admis : un outil d’IA en ligne est un destinataire de plus. Avant de confier le document d’un client à un assistant, trois passages de son contrat se relisent : la clause de confidentialité, la liste des sous-traitants autorisés, et une éventuelle clause sur l’IA.
Une règle en trois couleurs pour l’équipe
Une charte tient sur une page quand elle part d’un classement simple. Le plus parlant que nous connaissions est celui du feu tricolore : vert, orange, rouge. Chaque document reçoit sa couleur avant d’entrer dans un outil, et chacun sait où il peut aller.
| Couleur | Ce qu’elle couvre | Des exemples | Où elle peut aller |
|---|---|---|---|
| Vert | Ce qui est déjà public, ou détaché de toute personne et de tout secret. | Les pages de votre site, une fiche produit publiée, une question générale, le plan d’un article. | Tout outil validé par l’entreprise, avec un compte de l’entreprise. |
| Orange | L’interne courant, et les données personnelles réduites au nécessaire. | Une procédure, un compte rendu de réunion, un tableau de suivi, le nom et la fonction d’un contact. | Une offre pour les entreprises ou une API sous contrat, réglée pour exclure l’entraînement, dont le pays de traitement est connu. |
| Rouge | Le secret et le sensible : ce qui ferait du tort à l’entreprise, à un client ou à une personne s’il sortait. | Les mots de passe et les accès, les données bancaires, les marges et les prix de revient, les documents sous accord de confidentialité, les fichiers clients complets, les données de santé et les autres catégories que protège l’article 9 du RGPD. | Hors des outils d’IA en ligne. Un besoin réel passe par un outil installé chez vous, décidé avec le délégué à la protection des données, et, pour le document d’un client, par son accord écrit. |
L’orange demande le plus d’attention, parce qu’il se réduit souvent : une demande bien écrite garde la tâche et laisse les personnes de côté.
« Rédige une relance pour Mme Lefèvre, cliente depuis 2019, 14 rue des Tilleuls à Tours, au sujet de sa facture de mars restée impayée. »
Nom, adresse, ancienneté : la tâche se passe de ces trois informations.« Rédige une relance cordiale pour une cliente fidèle, au sujet d’une facture de mars restée impayée : rappel de l’échéance, proposition d’un échéancier. »
Le nom s’ajoute ensuite, dans votre logiciel. Exemple écrit pour cette note.Ce que nous gardons pour nous
Nous appliquons à notre propre travail une règle de cet ordre. Les accès et les mots de passe de nos clients restent hors des assistants d’IA, comme leurs fichiers clients. Quand une tâche demande des données d’un client, elle passe par une offre pour les entreprises ou une API sous contrat, réglée pour exclure l’entraînement, avec le strict nécessaire. Et chaque contenu produit avec l’IA est relu, vérifié et corrigé par un humain avant sa mise en ligne, comme le dit notre page Méthode.
Les outils que nous construisons suivent la même logique : le modèle employé, ses conditions, l’hébergement et les droits de chacun se décident avec l’entreprise. Notre page Logiciels et IA sur mesure décrit ces outils.
Avant d’adopter un outil
Avant d’ouvrir un outil à toute l’équipe, une liste courte vérifie l’essentiel. Elle vaut pour un assistant du marché comme pour un outil sur mesure.
Avant d’ouvrir un outil d’IA à l’équipe
0 cochée sur 11Vos cases restent cochées sur cet appareil. Rien n’est envoyé.
Quand l’outil du marché atteint ses limites, un outil construit pour l’équipe peut s’appuyer sur une API sous contrat et sur vos propres droits d’accès. Notre note sur le logiciel métier compare le standard et le sur-mesure.
Questions fréquentes
ChatGPT est-il conforme au RGPD ?
La conformité se juge à l’usage : l’offre, le contrat, les données saisies, les réglages. La CNIL invite chaque organisme à interroger son fournisseur sur la conformité de son système, et à formaliser leur relation par un contrat. Une offre pour les entreprises, avec son avenant sur le traitement des données, en pose les bases ; la suite dépend de ce que l’équipe y confie.
Peut-on confier des données clients à une IA ?
Oui, dans un cadre : une offre pour les entreprises ou une API sous contrat, réglée pour exclure l’entraînement, des données réduites au nécessaire, des personnes informées, des droits d’accès par rôle. Les données de santé, les fichiers complets et les documents sous accord de confidentialité relèvent du rouge : ils restent hors des outils en ligne.
Anonymiser un document suffit-il ?
Une anonymisation complète, qui rend impossible tout retour à la personne, sort la donnée du RGPD. Remplacer les noms par des initiales ou des codes relève de la pseudonymisation : la donnée reste personnelle tant qu’une information permet de la rattacher à quelqu’un. Dans un compte rendu, un poste, une ville et une date suffisent parfois à reconnaître une personne.
Faut-il une charte IA dans l’entreprise ?
La CNIL la recommande, avec les usages autorisés et les usages interdits. La fiche de France Num y ajoute la façon de vérifier les réponses et des modèles de demandes communs. La règle des trois couleurs en fait le cœur.
Un outil d’IA sur mesure protège-t-il mieux les données ?
Il permet de choisir chaque réglage : le modèle et ses conditions, une API sous contrat, le lieu d’hébergement, les droits de chacun, la durée de conservation. La CNIL rappelle qu’une entreprise qui relie un modèle à sa propre base de documents contenant des données personnelles en devient responsable : ces choix se font donc à la conception. Notre page Logiciels et IA sur mesure décrit les outils que nous construisons.
Sources et méthode
Ce qui décrit les offres vient de la documentation publique des éditeurs, relue le 1er novembre 2026 ; ce qui décrit le droit vient des textes, de la CNIL, de France Num, de l’ANSSI et de la Commission européenne, cités ci-dessous. Cette note décrit ces sources et tient lieu d’information, pour un premier regard. Ce qui est écrit en « nous » vient de notre pratique. La relance et ses personnes sont des exemples écrits pour cette note.
- How your data is used to improve model performanceOpenAI, centre d’aide
- Data Controls FAQ (discussions temporaires)OpenAI, centre d’aide
- Data controls in the OpenAI platformOpenAI, documentation de l’API
- Updates to Consumer Terms and Privacy Policy, 28 août 2025Anthropic
- How do you use personal data in model training? (produits commerciaux), 16 mars 2026Anthropic, centre de confidentialité
- Confidentialité des applications GeminiAide Gemini
- L’IA générative dans Google Workspace : centre de confidentialité, mis à jour le 6 octobre 2026Google Workspace
- Gemini API Additional Terms of Service, mis à jour le 28 avril 2026Google AI for Developers
- Données, confidentialité et sécurité pour Microsoft Copilot, 9 juillet 2026Microsoft Learn
- Contrôles de confidentialité de Microsoft CopilotSupport Microsoft
- Données, confidentialité et sécurité pour les modèles vendus par Azure dans Microsoft Foundry, 18 mai 2026Microsoft Learn
- Can I opt out of my input or output data being used for training?, 3 septembre 2026Mistral AI, centre d’aide
- Do you use my user data to train your artificial intelligence models?Mistral AI, centre d’aide
- Règlement (UE) 2016/679, le RGPD : articles 4, 9, 28, 44 à 49, considérant 26EUR-Lex
- Les questions-réponses de la CNIL sur l’utilisation d’un système d’IA générative, 18 juillet 2024CNIL
- Fiche 4 : prendre les précautions indispensables à un usage responsable et sécurisé, novembre 2024France Num, avec la CPME et la CNIL
- Transférer des données hors de l’UECNIL
- Transferts de données vers les États-Unis : la Commission européenne adopte une nouvelle décision d’adéquation, 10 juillet 2023CNIL
- European Court of Justice to Review Challenge to EU-U.S. Data Privacy Framework, 1er décembre 2025WilmerHale, blog
- Recommandations de sécurité pour un système d’IA générative, recommandation 34ANSSI
- Règlement sur l’IA, calendrier d’application, mis à jour le 19 octobre 2026Commission européenne
- AI Literacy, Questions & Answers, mis à jour le 20 octobre 2026Commission européenne
- Code de commerce, article L151-1 (secret des affaires)Légifrance
Sur le même sujet
 IA
 Pour comprendre Lire la note Logiciel métier : ce que c’est, et comment choisir entre standard et sur mesure
 Outils métier Pour comprendre Lire la note Pratiques SEO à éviter : ce que nous avons écarté, et ce que nous faisons à la place
 Stratégie Pour comprendre Lire la note