En bref
La navigation à facettes, ce sont les filtres d’une page de catégorie : la matière, la taille, la couleur, le prix, le tri. Chaque combinaison crée une adresse, et Google la désigne comme la source la plus courante, et de loin, des cas de surexploration que lui signalent les sites. Un filtre qui répond à une vraie recherche, « brouette acier » par exemple, devient une page de catégorie à part entière : une adresse propre, un titre, un texte, des liens. Les autres restent au service du client, et hors de Google : le robots.txt ferme leur exploration, la canonique les regroupe sur la catégorie, la balise noindex les retire de l’index. Chaque famille de filtres reçoit un seul de ces moyens, choisi selon ce qu’elle vaut.
Chaque filtre d’une boutique crée une adresse, et leurs combinaisons en créent des milliers. Quelques-unes répondent à une vraie recherche et méritent leur place dans Google ; les autres servent le client sur la page. Voici comment les trier, et les moyens que Google documente pour chacune.
Notre note sur les fiches produits s’arrêtait sur une idée : les filtres d’une boutique posent le même problème que les variantes d’un produit, en plus grand. Voici la suite. Elle parle des pages de catégorie et de leurs filtres ; la fiche elle-même, son titre et ses variantes ont leur note, Fiche produit SEO : ce que Google lit vraiment.
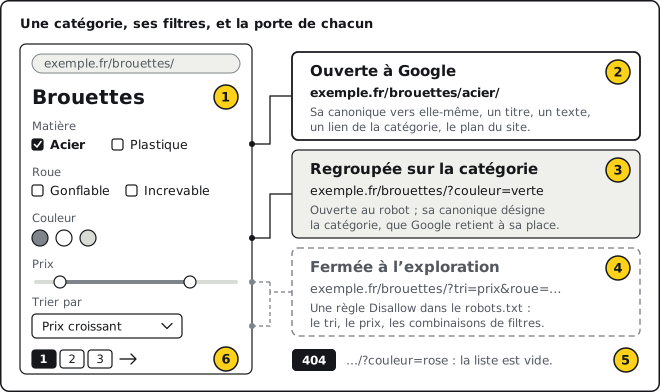
- La catégorie et les adresses que fabriquent ses filtres
- Le filtre ouvert, devenu une vraie page de catégorie
- Le filtre regroupé sur la catégorie, par la canonique
- Le filtre fermé à l’exploration, par le robots.txt
- La liste vide, qui répond 404
- La pagination, qui suit ses propres règles
La navigation à facettes, en une définition
Navigation à facettesnom féminin ; on dit aussi navigation par filtres, ou par attributs
Les filtres d’une page de liste, qui laissent le visiteur réduire et ranger les produits selon leurs propriétés : la matière, la taille, la couleur, la marque, le prix, l’ordre d’affichage. Chaque propriété est une facette. Chaque choix change la liste, et le plus souvent l’adresse de la page, avec un paramètre comme ?couleur=verte.
Voir aussi la section 3, sur les moyens que Google documente.
Le client y gagne : il trouve vite la brouette qu’il cherche. Le robot, lui, voit une adresse nouvelle à chaque clic, et doit souvent la lire pour découvrir qu’elle répète une liste déjà vue. Prenons une catégorie avec trois matières, quatre types de roue, cinq couleurs et quatre ordres de tri : avec une valeur par filtre au plus, elle produit déjà 480 adresses ; avec plusieurs valeurs cochées par filtre, plus de 16 000. C’est un exemple calculé pour cette note, sur une seule catégorie.
Google range la navigation à facettes en tête, et de loin, des cas de surexploration que lui signalent les propriétaires de sites : il l’écrivait en annonçant sa page de documentation sur le sujet, le 17 décembre 2024. Ses robots passent du temps sur des adresses qui répètent la même liste, et ce temps manque pour découvrir les pages nouvelles.
« Le budget d’exploration, c’est l’affaire des très grands sites. Une petite boutique peut laisser ses filtres tranquilles. »
Google réserve son guide sur le budget d’exploration aux très grands sites : plus d’un million de pages, ou plus de 10 000 qui changent chaque jour. Une boutique de quelques centaines de produits est concernée autrement. Ses filtres fabriquent des listes presque identiques, et Google choisit seul celle qu’il montre. Trier ses filtres sert d’abord à décider quelle page porte chaque recherche.
Les filtres qui méritent une page
Un filtre mérite sa place dans Google quand il répond à une recherche que des clients tapent vraiment : « brouette acier », « chaussures de randonnée femme », « canapé convertible vert ». Il devient alors une page de catégorie à part entière, et se traite comme telle : une adresse lisible et stable, une canonique vers elle-même, un titre de page et un h1 qui reprennent la recherche, quelques lignes de texte utiles au client, un lien depuis la catégorie, une place dans le plan du site. Google le demande pour toute page indexable : la même adresse dans les liens internes, le plan du site et la canonique.
Pour trouver ces recherches, nous partons de ce que la boutique reçoit déjà : le rapport Performances de Search Console, la recherche interne du site, les suggestions de Google, les termes de recherche des campagnes Google Ads. Une recherche qui revient, avec assez de produits pour remplir la page, justifie une page ; les autres filtres attendent une preuve.
| Le filtre | Exemple | Le plus souvent |
|---|---|---|
| La matière, le type, l’usage | brouette acier, brouette électrique | Une vraie recherche : une page ouverte, avec son texte. |
| La marque | brouette [marque] | Ouverte quand la marque est cherchée, avec plusieurs modèles en rayon. |
| La couleur | canapé vert | Ouverte dans les rayons où la couleur se cherche, la mode et la maison ; regroupée ailleurs. |
| La taille, la pointure | taille 42 | Regroupée sur la catégorie : la taille se cherche rarement seule. |
| Le prix, la disponibilité, la note | petit prix, en stock | Au service du client : fermée à l’exploration. |
| Le tri | prix croissant, nouveautés | La même liste dans un autre ordre : fermée à l’exploration. |
| Deux filtres ou plus | acier, roue gonflable, vert | Fermée ; une combinaison précise s’ouvre quand elle répond à une recherche. |
Un filtre ouvert gagne à recevoir une adresse en chemin, exemple.fr/brouettes/acier/, plutôt qu’en paramètre : elle se lit mieux, et reste à l’écart des règles du robots.txt qui ferment les paramètres de filtre.
Les moyens que Google documente
Pour les filtres qui restent au service du client, Google décrit ses moyens dans sa page sur l’exploration des URL de navigation à facettes, publiée fin 2024 et mise à jour depuis, et dans celle sur la pagination. Ils agissent à des moments différents : avant l’exploration, pendant l’indexation, ou sur le choix de l’adresse retenue.
| Le moyen | Ce qu’il fait | Ce qu’il faut savoir |
|---|---|---|
| Une règle Disallow dans le robots.txt | Ferme l’exploration des adresses filtrées. Google le cite en premier. | Il règle l’exploration. Une adresse fermée peut rester dans l’index, réduite à son adresse, si des liens y mènent. |
| Des filtres après un # | Google laisse de côté ce qui suit le dièse pour explorer et indexer. | Un effet neutre sur l’exploration. Un filtre qui mérite sa page garde une vraie adresse. |
| La balise canonical | Désigne la catégorie comme adresse de référence ; à terme, Google explore moins les versions filtrées. | Un indice, et Google garde le choix final. Plus lent que le robots.txt, et moins sûr sur la durée, d’après Google. |
| La balise noindex | Retire la page de l’index. | Google doit lire la page pour voir la balise : elle reste ouverte à l’exploration. |
| L’attribut nofollow sur les liens | Décourage le robot de suivre les liens de filtre. | Efficace seulement sur chaque lien vers ces pages, y compris ceux venus d’autres sites. |
| Une réponse 404 | Pour une combinaison qui donne une liste vide, un filtre en double, une page au-delà de la dernière. | Servie à l’adresse demandée, plutôt qu’une redirection vers une page d’erreur générale. |
Google classe le robots.txt et le dièse parmi les moyens les plus efficaces sur la durée ; la canonique et le nofollow agissent plus lentement. Quand les adresses filtrées ont peu de raisons d’être indexées, il conseille de les fermer dans le robots.txt, et de laisser ouvertes les fiches produits et une page de liste complète.
# Les filtres réservés au client, fermés à l'exploration
User-agent: *
Disallow: /*?*tri=
Disallow: /*?*prix=
Disallow: /*?*dispo=
Disallow: /*?*[autre-parametre]=

Sitemap: https://exemple.fr/sitemap.xml
L’étoile tient lieu de toute suite de caractères : la première règle ferme toute adresse qui porte un paramètre tri, sur toutes les pages. Une règle trop large fermerait aussi un filtre ouvert, d’où l’adresse en chemin.
« Un filtre bloqué dans le robots.txt disparaît de Google. »
Le robots.txt règle l’exploration, et l’index suit d’autres règles. Google le rappelle dans sa présentation du fichier : une adresse fermée peut rester dans ses résultats, réduite à son adresse, si des liens y mènent. Pour sortir une page de l’index, il faut une balise noindex, sur une page que le robot peut lire.
Trois portes, un seul moyen par famille
Ces moyens se contrarient quand on les empile. Une page fermée dans le robots.txt garde pour elle sa balise noindex et sa canonique : le robot s’arrête à la porte. Google l’écrit dans sa documentation sur noindex comme dans celle sur les adresses en double : le robots.txt sert l’exploration, la canonique et le noindex servent l’index, et pour choisir une adresse de référence à l’intérieur d’un site, la canonique convient mieux que le noindex.
fermée à l’exploration,
la page garde ses consignes pour elle
Nous donnons donc à chaque famille de filtres une seule des trois portes du dessin.
Une famille déjà indexée se retire en deux temps. D’abord la balise noindex, sur des pages encore ouvertes, le temps que Google les relise ; ensuite la règle du robots.txt, une fois les pages sorties de l’index. Une famille encore inconnue de Google se ferme d’emblée.
La pagination, une page à part entière
La pagination suit d’autres règles que les filtres. La page 2 d’une catégorie montre d’autres produits que la page 1 : Google la traite comme une page distincte. Sa documentation sur la pagination demande :
- une adresse par page, avec un paramètre comme ?page=2 ;
- une canonique propre à chaque page, la page 2 désignant la page 2 ;
- des liens
<a href>d’une page à la suivante, et un lien vers la première depuis toutes les autres ; - de vrais liens derrière un bouton « Voir plus » ou un défilement infini : Google suit les liens des balises a, et laisse de côté les boutons et les gestes du visiteur.
Google a cessé de lire les balises rel=“next” et rel=“prev”, que d’autres moteurs emploient encore, et les pages d’une même série peuvent garder le même titre. Une page filtrée et paginée suit le sort de son filtre : la page 2 d’une famille fermée reste fermée.
Des paramètres d’URL bien écrits
Search Console a longtemps proposé un outil pour expliquer à Google le rôle de chaque paramètre. Google l’a retiré un mois après son annonce du 28 mars 2022 : ses robots triaient désormais seuls les paramètres, et 1 % environ des réglages enregistrés servaient encore, d’après cette annonce. Le robots.txt a pris le relais.
Pour les adresses filtrées qui restent ouvertes, Google recommande une écriture simple :
- le séparateur
&entre les paramètres ; la virgule, le point-virgule et les crochets brouillent sa lecture ; - la forme clé=valeur, ?couleur=verte plutôt que ?verte ;
- dans un chemin, un ordre des filtres toujours le même, et chaque filtre une seule fois ;
- une réponse 404 pour une combinaison qui donne une liste vide, servie à l’adresse demandée ;
- des liens internes débarrassés des paramètres temporaires : identifiant de session, code de suivi.
Google le reconnaît : une boutique bâtie sur une plateforme a souvent ces réglages faits d’avance. Sur Shopify, le robots.txt par défaut ferme les collections triées et les combinaisons de filtres, et Dawn, le thème que Shopify publie comme modèle, désigne la collection comme canonique de ses versions filtrées (relevé du 1er novembre 2026). Un filtre qui mérite sa page y devient une collection : c’est l’objet de notre note sur le référencement Shopify.
Ce que nous regardons, dans l’ordre
- Relever les adresses filtréesCelles que Google connaît, dans le rapport sur l’indexation des pages, et celles que fabriquent les filtres, comptées par un robot d’exploration.
- Lister les recherches réellesCelles qui reviennent dans le rapport Performances et la recherche interne, et les filtres qui y répondent.
- Choisir une porte par familleOuverte, regroupée ou fermée : une décision par famille de filtres, notée dans un tableau avec sa raison.
- Donner une page aux filtres ouvertsUne adresse en chemin, une canonique vers elle-même, un titre de page, un h1 et quelques lignes de texte, un lien depuis la catégorie, une place dans le plan du site.
- Retirer de l’index, puis fermerPour une famille déjà indexée, la balise noindex d’abord, la règle du robots.txt ensuite. Les listes vides répondent 404.
- Suivre, à date notéeLe rapport sur l’indexation des pages, mois après mois ; les statistiques d’exploration pour les boutiques de plus de mille pages, seuil que Google donne pour ce rapport.
- Indexation
- Pages
Avant d’ouvrir ou de fermer un filtre, nous passons cette liste. Cochez au fil de votre relecture.
Avant d’ouvrir ou de fermer un filtre
0 cochée sur 6Vos cases restent cochées sur cet appareil. Rien n’est envoyé.
Questions fréquentes
Noindex ou robots.txt : lequel choisir pour les filtres ?
Le robots.txt pour arrêter l’exploration d’une famille entière : c’est le moyen que Google cite en premier pour les filtres à tenir hors de l’index. La balise noindex pour faire sortir de l’index une page qui y est déjà : elle demande que le robot puisse lire la page. Pour une famille déjà indexée, nous passons par les deux, dans cet ordre : noindex, puis robots.txt.
Une page filtrée peut-elle se positionner sur Google ?
Oui, quand elle répond à une recherche et qu’elle se présente comme une vraie page de catégorie : une adresse stable, un titre et un texte propres, des liens qui y mènent. Pour une recherche précise comme « brouette acier », c’est souvent la page la plus juste de la boutique. Un audit SEO relève ces recherches, et les adresses que vos filtres fabriquent déjà.
Des filtres en JavaScript règlent-ils la question ?
Ils la déplacent. Des filtres écrits après un dièse, dans l’adresse, restent hors du champ de Google, pour le meilleur et pour le pire : un filtre qui mérite sa page a besoin d’une vraie adresse et d’un lien <a href>, que Google suit. Le choix se fait donc filtre par filtre, comme pour le reste.
Sources et méthode
Ce qui décrit le fonctionnement de Google et de Search Console vient de leur documentation publique, citée ci-dessous ; ce qui concerne Shopify vient de sa documentation et d’un relevé sur ses boutiques. Ce qui est écrit en « nous » vient de notre pratique. La catégorie de brouettes, ses adresses et le calcul des combinaisons sont des exemples écrits pour cette note.
- Gérer l’exploration des URL de navigation à facettes, mise à jour le 6 mars 2026Google, documentation sur l’exploration
- Décembre : exploration et navigation à facettes, 17 décembre 2024Google Search Central, blog
- Pagination, chargement incrémentiel des pages et impact sur la recherche GoogleGoogle Search Central, documentation
- Concevoir une structure d’URL pour les sites d’e-commerceGoogle Search Central, documentation
- Aider Google à comprendre la structure de votre site d’e-commerceGoogle Search Central, documentation
- Les adresses en double et l’URL canoniqueGoogle Search Central, documentation
- Présentation du fichier robots.txtGoogle Search Central, documentation
- Bloquer l’indexation avec noindexGoogle Search Central, documentation
- Optimiser votre budget d’explorationGoogle, documentation sur l’exploration
- Nettoyage de printemps : l’outil Paramètres d’URL, 28 mars 2022Google Search Central, blog
- Le rapport sur l’indexation des pagesAide de Search Console
- Le rapport Statistiques sur l’explorationAide de Search Console
- Personnaliser le robots.txtShopify, documentation pour les développeurs
Sur le même sujet
 Référencement naturel
 Pour agir Lire la note Référencement Shopify : ce que la plateforme fait seule, ce qui reste à faire Référencement naturel Pour agir Lire la note Le maillage interne, expliqué avec un plan de métro Référencement naturel
 Technique Lire la note