En bref
Une page zombie, dans le jargon des référenceurs, est une page en ligne qui dort : peu de visites venues de Google, peu de liens, peu d’intérêt pour le visiteur qui y arrive. Doublons, contenus périmés, vieilles promotions, pages maigres créées par un outil : elles se repèrent dans les rapports Indexation des pages et Performances de Search Console, complétés par un robot d’exploration et les statistiques de visites. Chacune reçoit ensuite son sort : la garder et l’améliorer, la fusionner avec une voisine puis la rediriger, la sortir de l’index, ou la supprimer avec un code 404 ou 410. Google réserve la suppression aux pages impossibles à améliorer, et note que retirer les contenus inutiles peut aider les contenus utiles du même site.
Sur beaucoup de sites, une partie des pages dort : peu de visites, peu de liens, un sujet traité ailleurs ou une offre périmée. Voici comment nous les repérons dans Search Console, comment nous décidons du sort de chacune, et ce que Google dit de ce tri.
Un site vit des années, et il garde la trace de chacune : l’actualité d’une ancienne saison, la page des soldes d’un été passé, la fiche d’un produit arrêté, les pages d’étiquettes créées par le blog, le doublon laissé par une refonte. Prises une à une, ces pages semblent inoffensives. Ensemble, elles brouillent l’image que le visiteur et Google se font du site.
Le tri se fait avec des chiffres, page par page, et il mène à quatre issues.
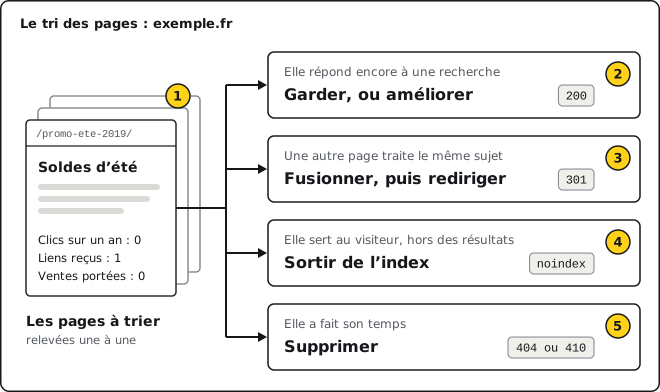
- Les pages à trier : l’inventaire, dans Search Console
- Garder, ou améliorer : la page qui répond encore à une recherche
- Fusionner, puis rediriger : deux pages pour un même sujet
- Sortir de l’index : la page utile au visiteur, hors des résultats
- Supprimer : la page qui a fait son temps
Ce qu’on appelle une page zombie
Page zombienom féminin, jargon du référencement
Une page restée en ligne, souvent dans l’index de Google, qui apporte peu : peu de visites venues des résultats, peu de liens, peu de réponses pour le visiteur qui y arrive. Le mot vient du métier ; Google parle, lui, de contenu utile, ou de contenu écrit d’abord pour les moteurs.
Voir aussi la section 3, pour les repérer.
Ces pages se rangent en quelques familles.
| Famille | Exemples | Ce qui la signale |
|---|---|---|
| Les doublons | Une même page sous plusieurs adresses (tri, paramètre de suivi, barre finale) ; deux articles sur la même question ; des pages de ville au texte identique. | Le rapport d’indexation les range parmi les pages en double ; deux pages se partagent les mêmes recherches. |
| Les pages périmées | Une promotion terminée, un événement passé, une offre d’emploi pourvue, une actualité d’une ancienne année. | Des impressions qui fondent d’une année sur l’autre. |
| Les pages maigres | Une étiquette de blog qui liste deux articles, une archive d’auteur, une catégorie presque vide, une page de résultats de recherche interne. | Peu de texte propre, peu d’impressions, souvent « Explorée, actuellement non indexée ». |
| Les restes techniques | Une page de test, une ancienne version laissée après une refonte, une page créée par une extension puis oubliée. | Des adresses absentes du plan du site, trouvées par un robot d’exploration. |
| Les fiches de produits arrêtés | Un produit retiré du catalogue pour de bon. | Une fiche sortie des catégories, à l’écart des liens internes. |
Pourquoi elles pèsent sur un site
Pour le visiteur, d’abord. Celui qui arrive sur une promotion terminée ou sur un article d’une autre époque juge l’entreprise sur cette seule page.
Pour Google, ensuite. Ses systèmes de classement travaillent surtout page par page, et tiennent compte aussi de quelques signaux à l’échelle du site, comme il l’écrivait en mars 2024. Après une baisse importante, sa documentation sur les mises à jour principales conseille d’examiner le site dans son ensemble, en plus des pages les plus touchées, et précise que retirer les contenus inutiles peut améliorer les performances des contenus utiles.
La même page pose la limite. Google traite la suppression en dernier recours, pour les contenus que l’on juge impossibles à améliorer. Et quand des rubriques entières semblent bonnes à jeter, il y voit le signe qu’elles ont été écrites d’abord pour les moteurs, plutôt que pour les lecteurs.
Pour l’exploration, enfin, surtout sur les grands sites. Google appelle budget d’exploration l’ensemble des adresses que son robot peut et veut explorer sur un site. Son guide sur le sujet vise les sites de plus d’un million de pages qui changent chaque semaine, ceux de plus de 10 000 pages qui changent chaque jour, et ceux dont une grande part des adresses, connues de Google, attendent encore son passage. Pour les autres, Google estime qu’un plan du site à jour et un regard régulier sur le rapport d’indexation suffisent.
« Supprimer des pages en masse fait remonter un site. »
Google range parmi les signes d’un contenu écrit pour les moteurs le fait d’ajouter ou de retirer beaucoup de pages dans l’espoir de paraître plus récent, et répond que la technique échoue. Le tri sert le visiteur : chaque page retirée l’est pour une raison qui la concerne, chiffres à l’appui.
Les doublons relèvent d’un autre registre. Le guide de démarrage de Google l’écrit : le contenu en double reste hors du champ de ses règles contre le spam. Il brouille en revanche le choix du visiteur, qui hésite entre deux pages, et occupe le robot sur des adresses inutiles.
Les repérer dans Search Console
Le tri commence par un inventaire : toutes les adresses du site, avec pour chacune ce qu’elle rapporte. Search Console en fournit l’essentiel.
- Indexation
- Pages
| Ce que vous lisez | Où | Ce que cela suggère |
|---|---|---|
| « Explorée, actuellement non indexée » | Indexation des pages | Google a lu la page et l’a laissée de côté pour l’instant : souvent une page maigre, ou proche d’une autre. |
| Les lignes « Page en double… » | Indexation des pages | Plusieurs adresses pour un même contenu ; Google en a choisi une. |
| « Erreur soft 404 » | Indexation des pages | Une page qui affiche une erreur, ou presque vide, et répond comme une page normale. |
| Des impressions, très peu de clics, sur une longue période | Performances, onglet Pages | Une page montrée sur des recherches où elle répond mal, ou concurrencée par une autre page du site. |
| Une adresse absente du tableau des pages | Performances, comparé au plan du site | Une page restée invisible dans les résultats sur toute la période. |
| Une page en bas du classement des liens internes | Liens, Liens internes | Une page à l’écart du réseau, parfois orpheline. |
Google le rappelle dans l’aide du rapport : un site voit une partie seulement de ses adresses indexée, et c’est normal. Le but est la version de référence de chaque page importante ; les doublons et les variantes restent dehors.
Le chiffre de Google raconte une partie de l’histoire. Une page peu cliquée dans les résultats peut porter une campagne Google Ads, une lettre d’information, un lien envoyé aux clients ; d’autres, comme les mentions légales, servent par nature. Nous croisons donc trois sources de plus : les statistiques de visites, toutes origines confondues ; les liens venus d’autres sites, dans le rapport Liens ; et les demandes ou les ventes que la page a portées.
Notre inventaire suit le même ordre d’un site à l’autre :
- Lister toutes les adressesLe plan du site, un robot d’exploration qui suit les liens depuis l’accueil, et les pages vues dans Search Console. Une adresse connue d’une seule de ces sources mérite un regard.
- Relever ce que chaque page rapporteClics et impressions sur une année entière, pour couvrir les saisons ; visites toutes origines ; demandes et ventes.
- Noter les liensLes liens internes, et les liens venus d’autres sites, dans le rapport Liens de Search Console.
- Lire l’état de la page dans l’indexIndexée, en double, explorée et laissée de côté, en erreur.
- Décider, page par pageUne colonne de plus dans le tableau : le sort de la page, et sa raison.
Notre note sur le maillage interne détaille la recherche des pages orphelines avec un robot d’exploration.
Garder et améliorer ce qui répond encore
Une page qui dort répond souvent à une vraie question, mal. Elle a un sujet, des impressions, parfois des liens : la reprendre garde son adresse, ses liens et son historique. Le travail tient de la réécriture : la recherche visée, l’information remise à jour, la réponse placée en tête, des liens depuis les pages voisines. Notre note sur la rédaction SEO décrit cette méthode, et celle sur ce que Google regarde sur une page liste les éléments à reprendre.
Une mise à jour se date quand le fond change. Google cite, parmi les signes d’un contenu écrit pour les moteurs, la date modifiée sur une page restée la même.
Certaines pages restent telles quelles : les mentions légales, les conditions de vente, la page de contact, la page d’arrivée d’une campagne. Elles servent le client, et leur faible trafic venu de Google est dans l’ordre des choses.
Fusionner les doublons, puis rediriger
Deux pages qui traitent le même sujet se partagent les recherches, les liens et l’attention du lecteur. Nous gardons la meilleure, enrichie de ce que l’autre avait de bon ; l’ancienne adresse mène ensuite à la page gardée par une redirection permanente.
« Choisir son carrelage de salle de bain », écrit il y a quatre ans, et « Quel carrelage pour une douche à l’italienne ? », écrit l’an dernier. Chacun capte une partie des recherches et des liens.
Les deux pages se disputent les mêmes recherches.L’article récent reprend les conseils encore justes de l’ancien. L’ancienne adresse y mène par une redirection 301, et les liens internes pointent directement sur la page gardée.
Exemple écrit pour cette note.Google décrit la redirection permanente comme un signal fort : la page d’arrivée devient l’adresse de référence. Pour une même page servie sous plusieurs adresses, avec un tri ou un paramètre de suivi, la balise canonique fait le travail : elle désigne la version à montrer dans les résultats, et les variantes restent accessibles au visiteur.
Notre note sur les redirections 301 détaille le plan de redirections, les chaînes à éviter et les contrôles.
Sortir de l’index ce qui sert hors des résultats
Certaines pages servent le visiteur une fois sur le site, et gagnent à rester hors des résultats : la page de remerciement après un formulaire, les résultats du moteur de recherche interne, le panier, l’espace client, certaines pages d’étiquettes. La règle noindex les retire de l’index ; la page reste en ligne pour le visiteur.
<!-- Dans le <head> de la page -->
<meta name="robots" content="noindex">

# Ou dans la réponse du serveur, utile pour un PDF
X-Robots-Tag: noindex
Google pose deux précautions. La page reste ouverte à son robot : bloquée dans le fichier robots.txt, elle cache sa règle noindex, et l’adresse peut rester dans les résultats. Et la règle agit au passage suivant du robot, parfois des mois plus tard pour une page peu visitée ; l’outil d’inspection d’URL permet de demander ce passage.
Le noindex règle l’index, et lui seul. Google le précise dans son guide sur le budget d’exploration : son robot ouvre la page pour lire la règle, et l’exploration se poursuit donc.
Supprimer ce qui a fait son temps
Reste la page qui a fait son temps : son sujet a quitté l’offre, ses visites sont rares, ses liens aussi, et le site manque d’une page assez proche pour la remplacer. Elle répond alors 404 ou 410.
Google traite les deux codes de la même façon : il retire l’adresse de son index, puis l’explore de moins en moins souvent. Il l’écrivait dès 2011 : une adresse en 404 laisse intacte la place des autres pages du site dans ses résultats. Nous répondons 410 pour une page retirée exprès, parce que ce code dit l’intention, et 404 pour le reste.
Une page retirée qui reçoit encore des liens ou des visites, et qui a une voisine proche, prend plutôt une redirection vers elle. Et l’outil de suppression de Search Console masque une page pour six mois environ, d’après son aide : le retrait durable passe par le 404 ou le 410, un mot de passe, ou la règle noindex.
Les vieilles promotions demandent un tri à part.
| Situation | Ce que nous faisons | Réponse du serveur |
|---|---|---|
| Une opération qui revient chaque année : soldes, fête des mères, Black Friday | La même adresse d’une année sur l’autre, du type /soldes/, et la page mise à jour à chaque édition. | 200 |
| Une promotion ponctuelle terminée, qui reçoit encore des liens ou des visites | Une redirection vers la catégorie ou le produit concerné. | 301 |
| Une promotion ponctuelle terminée, oubliée de tous | Le retrait de la page. | 410 |
Pour les fiches de produits arrêtés, notre note sur les fiches produits donne le tableau des cas, de la rupture de stock au retrait définitif.
Avant de retirer, et après
Avant de retirer une page
0 cochée sur 7Vos cases restent cochées sur cet appareil. Rien n’est envoyé.
Nous retirons par lots, une famille de pages à la fois, et nous notons la date de chaque lot. Google prévient que certains effets se voient en quelques jours, et que ses systèmes peuvent mettre plusieurs mois à confirmer qu’un site s’est amélioré. Nous mesurons donc par groupe de pages, sur des périodes de même durée, avec la méthode de notre note sur le suivi de positionnement. Le rapport d’indexation suit le changement : les adresses redirigées passent dans « Page avec redirection », les pages en noindex dans « URL marquée “noindex” ».
L’indexation et les pages en double font partie de la technique que décrit notre page agence SEO ; notre audit SEO commence par l’état des lieux.
Ce que nous écartons
Supprimer des rubriques entières pour donner au site un air de neuf.
Parce que Google y lit le signe de pages écrites pour les moteurs, et que le tri se fait page par page, chiffres à l’appui.
Rediriger toutes les pages retirées vers l’accueil.
Parce que le visiteur arrive sur une page étrangère à sa recherche, et que Google peut la traiter comme une page introuvable.
Bloquer dans robots.txt une page à sortir de l’index.
Parce que le robot reste alors à la porte, que la règle noindex lui échappe, et que l’adresse peut rester dans les résultats.
Juger une page sur ses seuls clics venus de Google.
Parce qu’une page peu cliquée peut porter une campagne, des liens précieux ou des ventes.
Nos autres choix de méthode, et les pratiques que Google range parmi le spam, font l’objet de la note Pratiques SEO à éviter.
Questions fréquentes
Des pages zombies font-elles baisser tout le site ?
Google décrit des systèmes de classement qui travaillent surtout page par page, avec quelques signaux à l’échelle du site, et note que retirer les contenus inutiles peut améliorer les performances des contenus utiles. Le poids dépend donc de la part du site concernée : quelques pages faibles comptent moins qu’une rubrique entière écrite pour les moteurs.
Toutes les pages d’un site doivent-elles être indexées ?
Google prévient qu’un site voit une partie seulement de ses adresses indexée. Le but est la version de référence de chaque page importante ; les doublons et les variantes restent hors de l’index, et c’est l’état normal.
404 ou 410 : lequel choisir ?
Pour Google, les deux mènent au même résultat : l’adresse sort de l’index. Nous répondons 410 pour une page retirée exprès, et 404 pour le reste.
Le budget d’exploration concerne-t-il mon site ?
Google adresse son guide aux sites de plus d’un million de pages qui changent chaque semaine, à ceux de plus de 10 000 pages qui changent chaque jour, et à ceux dont beaucoup d’adresses, connues de Google, attendent encore son passage. Pour un site plus petit, un plan du site à jour et le rapport d’indexation suffisent, selon Google.
Combien de temps avant de voir l’effet du tri ?
Google parle de quelques jours pour certains changements, et de plusieurs mois pour que ses systèmes confirment l’amélioration d’un site. Nous notons la date de chaque lot, et nous comparons des périodes de même durée.
Sources et méthode
Ce qui décrit le fonctionnement de Google et de Search Console vient de leur documentation publique et de leur blog, cités ci-dessous. Le mot « page zombie » vient du jargon du métier. Ce qui est écrit en « nous » vient de notre pratique ; l’artisan, ses articles et la page de soldes sont des exemples écrits pour cette note.
- Les mises à jour principales de la recherche Google et votre site, mise à jour le 31 décembre 2025Google Search Central, documentation
- What web creators should know about our March 2024 core update and new spam policies, Chris Nelson, 5 mars 2024Google Search Central, blog
- Créer des contenus utiles, fiables et axés sur les personnes, mise à jour le 7 octobre 2026Google Search Central, documentation
- Gérer le budget d’exploration d’un grand site, mise à jour le 16 septembre 2026Google Search Central, documentation
- Le guide de démarrage du référencement, mise à jour le 18 décembre 2025Google Search Central, documentation
- Rapport sur l’indexation des pagesAide de Search Console
- Rapport sur les performancesAide de Search Console
- Outil de suppressionAide de Search Console
- Bloquer l’indexation avec noindexGoogle Search Central, documentation
- Les adresses en double et l’URL canoniqueGoogle Search Central, documentation
- Les codes de réponse HTTP et les robots de GoogleGoogle Search Central, documentation
- Do 404 errors hurt my site?, Susan Moskwa, 2 mai 2011Google Search Central, blog
- Best practices for Black Friday and Cyber Monday pages, Alan Kent, 26 octobre 2020Google Search Central, blog
Sur le même sujet
 Site et image de marque
 Technique Lire la note Le maillage interne, expliqué avec un plan de métro
 Référencement naturel Technique Lire la note Pratiques SEO à éviter : ce que nous avons écarté, et ce que nous faisons à la place
 Stratégie
 Pour comprendre Lire la note