En bref
Le SEO technique réunit ce qui permet à Google d’explorer les pages d’un site, de les afficher comme un navigateur, puis de les indexer : le robots.txt, les codes HTTP, HTTPS, le rendu du JavaScript, la version mobile, les adresses canoniques, le plan du site et une architecture peu profonde. Google fixe trois exigences minimales : Googlebot accède à la page, elle répond par le code 200, et son contenu peut être indexé. Le rapport « Indexation des pages » de Search Console dit ce qui a arrêté Google, adresse par adresse. Sur un site de quelques centaines de pages, le budget d’exploration pèse peu : le travail porte sur les doublons, les erreurs et le rendu.
Avant de classer une page, Google doit la trouver, l’afficher comme un navigateur, puis la ranger dans son index. Le SEO technique veille sur chacune de ces étapes. Voici ce qui peut arrêter une page en chemin, où le lire dans Search Console, et l’ordre dans lequel vérifier un site.
Une page passe quatre portes avant de paraître dans Google : l’exploration, le rendu, l’indexation, puis l’affichage sur une recherche. Le SEO technique tient les trois premières ; la quatrième se gagne avec le contenu et les liens. Le schéma suit une fiche produit d’un fabricant de mobilier de bureau sur ce trajet.
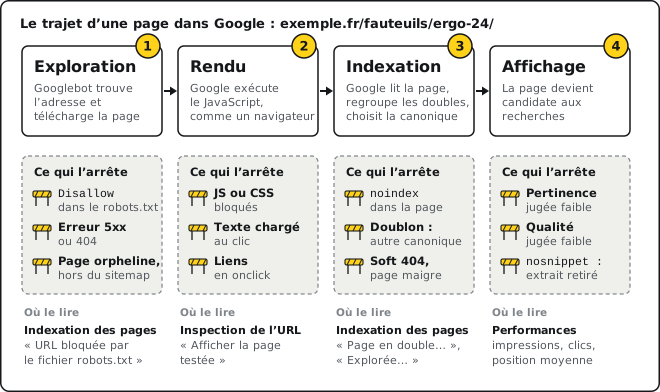
- L’exploration : Googlebot trouve et télécharge la page
- Le rendu : Google exécute le JavaScript
- L’indexation : Google range la page, ou l’écarte
- L’affichage : la page devient candidate aux recherches
Qu’est-ce que le SEO technique ?
Le SEO technique est la part du référencement qui rend un site lisible par les moteurs : Google y trouve chaque page utile, l’affiche correctement et la range dans son index. Il se distingue du travail sur le contenu de chaque page, le SEO on page, et des liens venus d’autres sites.
SEO techniquenom masculin ; on dit aussi référencement technique
L’ensemble des réglages du site et du serveur qui permettent aux robots d’un moteur d’explorer ses pages, de les afficher, de les indexer et de les comprendre : l’accès des robots, les codes de réponse, HTTPS, le rendu du JavaScript, la version mobile, les adresses canoniques, le plan du site, l’architecture des liens, la vitesse et les données structurées.
Voir aussi la section sur l’ordre de vérification.
Les Essentiels de la recherche de Google, mis à jour le 18 décembre 2025, fixent trois exigences techniques minimales : Googlebot accède à la page, la page répond par le code 200, et son contenu est indexable, du texte dans un format que Google lit, conforme à ses règles contre le spam. Ces conditions rendent une page éligible ; l’indexation reste la décision de Google. Notre note Référencement naturel : le guide place ce chantier à côté des contenus et des liens.
explorée, rendue, indexée :
ensuite seulement, classée
Comment Google explore un site ?
Google découvre les pages surtout en suivant les liens des pages qu’il connaît déjà, et grâce aux plans de site. Son robot, Googlebot, explore pour l’essentiel avec sa version pour smartphone, et lit chaque fichier jusqu’à une limite : les 2 premiers mégaoctets d’un fichier HTML, mesurés avant compression, d’après sa documentation mise à jour le 3 février 2026. Le chiffre de 15 Mo, souvent repris, vaut pour l’ensemble des robots de Google. Une page qui embarque des images encodées dans son code peut atteindre la limite, et Google lit alors une page coupée.
Reste la question que tout le monde pose : le budget d’exploration, l’ensemble des adresses que Google peut et veut explorer sur un site, selon la capacité du serveur et l’intérêt des pages.
« Notre site de 800 pages a un problème de budget d’exploration. »
Google réserve son guide sur le budget d’exploration aux sites de plus d’un million de pages qui changent chaque semaine, à ceux de plus de 10 000 pages qui changent chaque jour, et à ceux dont une grande part des adresses reste « Détectée, actuellement non indexée ». Pour les autres, un plan du site à jour et un regard régulier sur le rapport d’indexation suffisent, d’après sa documentation du 22 juillet 2026.
Sur un site de taille moyenne, ce que Google appelle gaspillage se corrige pour la clarté du site : des doublons, des pages supprimées qui répondent encore 200, des chaînes de redirections. Les pages qui dorment ont leur note : les pages zombies. Le rapport Statistiques sur l’exploration de Search Console, lui, vise les sites de plus de 1 000 pages, d’après son aide.
Le robots.txt, la porte d’entrée
Le fichier robots.txt, posé à la racine du site, dit aux robots les adresses qu’ils peuvent explorer. Une ligne de trop peut fermer une rubrique entière, ou le site, et c’est le premier fichier que nous ouvrons dans un audit.
Il règle l’exploration ; pour sortir une page de l’index, l’outil est la balise noindex, sur une page que le robot peut lire. Sa syntaxe, les erreurs qui coûtent cher et les robots des IA font l’objet de notre note Robots.txt : le guide, de la syntaxe aux robots des IA.
Le rendu : ce que Google voit après le JavaScript
Le rendu est l’étape où Google exécute le JavaScript d’une page, comme un navigateur, pour lire ce qu’elle affiche vraiment. Sa documentation, mise à jour le 4 mars 2026, décrit trois phases : l’exploration, le rendu avec une version à jour de Chromium, puis l’indexation à partir du HTML obtenu. Trois points se vérifient sur tout site construit avec un thème riche ou un cadre JavaScript :
- Les liens. Google suit les liens écrits comme une balise
<a>avec un attributhref; un menu qui navigue paronclicklui cache des pages. - Le contenu. Le texte principal se charge de lui-même, avant tout geste du visiteur, comme le demande la documentation sur l’indexation mobile d’abord.
- Les fichiers. Google exécute seulement le JavaScript qu’il a le droit de lire : un robots.txt qui ferme les scripts du thème prive le rendu de ses pièces.
Google conseille le rendu côté serveur ou le prérendu : le HTML arrive complet, plus vite pour les visiteurs, et lisible aussi par les robots qui s’en tiennent au HTML.
- Inspection de l’URL
- Tester l’URL active
- Afficher la page testée
L’indexation mobile d’abord
Google indexe et classe les pages à partir de leur version mobile, explorée par son robot pour smartphone. Le passage s’est achevé après le 5 juillet 2024, annonçait Google sur son blog le 3 juin 2024, en précisant qu’un site inaccessible sur téléphone sort de l’index. La version mobile porte donc tout : le texte, les titres, les images et leur texte alternatif, les données structurées, les balises meta.
Sur téléphone, le thème retire du HTML le tableau des caractéristiques et le texte d’usage, gardés pour l’ordinateur.
Google indexe la version allégée : ces informations sortent de sa lecture.Le contenu est le même ; sur téléphone, le tableau se replie dans un accordéon présent dans le HTML.
La recommandation de Google : un contenu principal équivalent. Exemple écrit pour cette note.Que dit le rapport « Indexation des pages » ?
Le rapport « Indexation des pages » de Search Console range chaque adresse connue de Google en deux groupes, les pages indexées et les pages écartées, et donne pour chaque page écartée son motif. Il se trouve dans le menu Indexation, à la ligne Pages. Google en pose la règle de lecture : un site voit une partie seulement de ses adresses indexée, et c’est normal ; l’objectif est la version canonique de chaque page importante.
Voici les motifs qui demandent le plus souvent une décision ; les erreurs serveur et les 404 suivent la logique des codes HTTP, plus bas.
| Motif affiché | Ce qu’il veut dire | Ce que l’on fait |
|---|---|---|
| « URL bloquée par le fichier robots.txt » | Une règle Disallow ferme l’adresse à l’exploration. | Vérifier que la règle vise bien une zone à tenir à l’écart ; sinon, l’ouvrir. |
| « Détectée, actuellement non indexée » | Google connaît l’adresse et a reporté sa visite. | Sur un petit site : des liens internes vers la page, et sa place dans le plan du site. |
| « Erreur soft 404 » | La page répond 200 et affiche une erreur, ou une page presque vide. | La faire répondre 404 ou 410, ou lui donner un vrai contenu. |
| « URL marquée “noindex” » | La page demande à rester hors de l’index. | Vérifier que c’est voulu : un noindex de préproduction reste souvent après la mise en ligne. |
| « Page en double sans URL canonique sélectionnée par l’utilisateur » | Google a trouvé un double, et a choisi seul la page à garder. | Poser une canonique sur chaque modèle de page. |
| « Page en double : Google a choisi une autre URL canonique que l’utilisateur » | Vos signaux se contredisent. | Aligner la canonique, les liens internes, le plan du site et les redirections. |
| « Explorée, actuellement non indexée » | Google a lu la page et l’a laissée de côté pour l’instant. | Juger la page : maigre, proche d’une autre ? L’enrichir, ou la fusionner. |
Deux lignes décrivent un état sain : « Autre page avec balise canonique correcte » et « Page avec redirection ». Pour les autres, la lecture part du modèle de page : des centaines de fiches en soft 404 viennent le plus souvent d’un même gabarit. Une fois la cause traitée, le bouton Valider la correction demande à Google de revérifier les adresses du motif.
La balise canonique et le contenu dupliqué
La balise canonique désigne, parmi plusieurs adresses qui montrent le même contenu, celle que Google doit retenir et afficher. Les doubles naissent de façon banale : http et https, avec et sans www, un paramètre de suivi, une liste triée, une version de démonstration restée ouverte. Google l’écrit dans sa page sur la canonicalisation, mise à jour le 20 août 2026 : un peu de contenu dupliqué est normal, et reste hors du champ de ses règles contre le spam.
<link rel="canonical" href="https://exemple.fr/fauteuils/ergo-24/">Google choisit lui-même la canonique, à partir de signaux qu’il additionne, d’après sa documentation du 10 juillet 2026 :
- la redirection 301, signal fort, quand un double disparaît ;
- la balise canonique, signal fort, y compris d’une page vers elle-même ;
- le plan du site, signal faible, qui liste les canoniques seules ;
- HTTPS, que Google préfère à http ;
- les liens internes, tous dirigés vers l’adresse canonique.
Google décrit deux erreurs : fermer un double dans le robots.txt, ce qui empêche le robot de lire sa canonique, et poser noindex pour choisir entre deux pages, ce qui retire la page de la recherche. Pour les filtres d’une boutique, voir notre note sur la navigation à facettes.
Le sitemap, la liste des pages à indexer
Le sitemap, ou plan du site, est un fichier XML qui liste les adresses que vous souhaitez voir dans Google. Sa documentation, mise à jour le 8 juillet 2026, le décrit comme un simple indice pour la découverte. Il se déclare dans le rapport Sitemaps de Search Console, et d’une ligne Sitemap dans le robots.txt.
Le rapport « Indexation des pages » se filtre sur les adresses envoyées par le plan du site : c’est la meilleure vue sur les pages que vous voulez vraiment dans Google.
HTTPS et codes HTTP : ce que le serveur répond
Chaque page répond au robot par un code HTTP, et Google agit selon ce code : il passe une page en 200 à l’indexation, suit une redirection, retire une page en 404, ralentit devant une erreur 500.
| Code | Ce que fait Google | Quand l’employer |
|---|---|---|
| 200 | Passe la page à l’indexation, qui reste son choix. | Toute page qui existe. |
| 301 ou 308 | Signal fort : la cible devient la page retenue. Google suit jusqu’à dix redirections à la suite. | Une page déplacée pour de bon. |
| 302 ou 307 | Signal faible en faveur de la cible. | Un déplacement provisoire. |
| 404 ou 410 | La page sort de l’index ; le robot repasse de moins en moins souvent. | Une page retirée, quand le site manque de page proche pour la remplacer. |
| 500, 503 ou 429 | Google ralentit son exploration ; si l’erreur dure, les pages finissent par sortir de l’index. | Une maintenance courte, en 503. |
HTTPS chiffre l’échange entre le visiteur et le serveur ; Google préfère la version https d’une page, et Search Console a un rapport HTTPS depuis septembre 2022. Google range HTTPS parmi les aspects de l’expérience sur la page, et précise, dans sa documentation mise à jour le 22 septembre 2026, que seuls les Core Web Vitals, parmi eux, entrent dans ses systèmes de classement. La règle tient en une ligne : une seule version du site, en https, vers laquelle toutes les autres redirigent en 301. Les redirections d’une refonte ont leur note : Redirections 301 et refonte.
Une architecture peu profonde
Une architecture peu profonde place chaque page importante à quelques clics de l’accueil, par des liens que le robot peut suivre. Google peut tenir compte du nombre de liens à suivre pour atteindre une page, et juge l’importance relative d’une page aux liens qu’elle reçoit du reste du site, d’après sa documentation sur la structure des sites d’e-commerce, mise à jour le 10 décembre 2025.
Des produits accessibles seulement par la recherche interne restent hors de vue : Googlebot remplit rarement les champs de recherche. Chaque page qui compte reçoit donc au moins un lien depuis une autre page du site. Notre note sur le maillage interne montre comment mesurer cette profondeur et retrouver les pages orphelines.
Deux chantiers voisins complètent la base, chacun avec sa note : la vitesse, mesurée par les Core Web Vitals, et les données structurées, qui décrivent la page en langage machine.
Dans quel ordre vérifier son SEO technique ?
Nous vérifions un site dans l’ordre du trajet d’une page, car chaque étape suppose la précédente : une page fermée à l’exploration se moque de sa canonique.
- Une seule version du siteLes quatre formes de l’adresse, http et https, avec et sans www, mènent en une redirection 301 à la même version en https.
- Le robots.txtChaque ligne Disallow vise une zone à tenir à l’écart ; les fichiers CSS et JavaScript du thème restent ouverts.
- Le rapport Indexation des pagesLes motifs, un par un, en commençant par ceux qui touchent les pages qui vendent.
- Les pages types, une par uneL’inspection de l’URL sur l’accueil, une rubrique, une fiche, un article : indexation, canonique retenue, texte présent après rendu.
- Le plan du site et les liensLe plan du site liste les canoniques ; un robot d’exploration lancé depuis l’accueil retrouve toutes les pages importantes.
Viennent ensuite la vitesse et les données structurées. Voici cet ordre appliqué à un site imaginaire.
Un site de 800 pages utiles : produits, gammes, articles, finitions. Six mois après la refonte, Search Console connaît 1 900 adresses et en indexe 430. Trois motifs dominent : « Détectée, actuellement non indexée » pour 820 adresses de configurateur, « Page en double sans URL canonique sélectionnée par l’utilisateur » pour 240 adresses, « Erreur soft 404 » pour 60 fiches.
- Une seule version. Les adresses en http et sans barre finale répondaient 200 : une redirection 301 les mène à la version https, et chaque modèle porte sa canonique.
- Le robots.txt. Le fichier hérité de la préproduction fermait le dossier des scripts du thème : la règle part, et l’inspection de l’URL montre enfin le tableau des caractéristiques dans le HTML rendu.
- Le configurateur. Le choix de finition s’écrit désormais après un dièse, que Google laisse de côté ; les anciennes adresses à paramètre portent une canonique vers leur fiche.
- Les produits arrêtés. Les 60 fiches en soft 404 répondent 410, ou 301 vers le modèle qui les remplace.
- Le suivi. Valider la correction pour chaque motif, la date notée, puis une lecture du rapport chaque mois.
Résultat : trois mois plus tard, Google indexe 720 des 800 pages utiles, les adresses connues redescendent à 1 050, et les clics vers les pages de gammes passent de 1 900 à 2 300 par mois, à saison comparable. Un signal, que l’entreprise suit encore avant de conclure.
Exemple écrit pour cette note : l’entreprise et les chiffres sont inventés.
Briefer un développeur, et relire ce qu’il rend
Un brief technique tient en une page : le constat, une adresse d’exemple, le résultat attendu, et la façon de le vérifier. Les motifs de Search Console donnent le vocabulaire commun ; la relecture se fait avec les mêmes outils, ceux de notre travail d’agence SEO.
Ce que vous vérifiez dans ce qu’on vous rend
0 cochée sur 6Vos cases restent cochées sur cet appareil. Rien n’est envoyé.
Pour un premier regard extérieur, notre audit SEO suit ce même trajet, page type par page type.
Questions fréquentes
Qu’est-ce que le SEO technique ?
Le SEO technique réunit les réglages qui permettent à Google d’explorer, d’afficher, d’indexer et de comprendre les pages d’un site : robots.txt, codes HTTP, HTTPS, rendu du JavaScript, version mobile, adresses canoniques, plan du site et architecture des liens. Il rend une page éligible aux résultats. Le contenu et les liens lui font ensuite gagner sa place.
Combien de temps faut-il pour qu’une page soit indexée ?
Pour une demande faite dans l’inspection de l’URL, l’aide de Search Console parle de quelques jours à deux semaines, et l’indexation reste la décision de Google. Une page reliée depuis le menu et listée dans le plan du site se fait découvrir plus vite.
Un site de quelques centaines de pages doit-il surveiller son budget d’exploration ?
Google réserve son guide sur le budget d’exploration aux très grands sites : plus d’un million de pages qui changent chaque semaine, ou plus de 10 000 qui changent chaque jour. Pour un site de quelques centaines de pages, un plan du site à jour et une lecture régulière du rapport d’indexation suffisent, d’après sa documentation du 22 juillet 2026. L’effort porte alors sur les doublons, les erreurs et le rendu.
Le SEO technique compte-t-il pour les IA ?
Les IA qui cherchent sur le web lisent les pages avec leurs propres robots, que le robots.txt et le pare-feu laissent passer ou arrêtent. Pour ses aperçus IA, Google choisit ses liens parmi les pages indexées et éligibles à un extrait. Un site bien exploré et bien indexé part donc avec une longueur d’avance, dans Google comme dans les réponses des IA.
Sources et méthode
Ce qui décrit Google, Googlebot et Search Console vient de leur documentation publique, citée ci-dessous avec sa date de mise à jour. Ce qui est écrit en « nous » vient de notre pratique. Le fabricant de mobilier, son site et ses chiffres sont un exemple écrit pour cette note, comme le code de la canonique.
- Le fonctionnement de la recherche Google, mis à jour le 18 décembre 2025Google Search Central, documentation
- Les exigences techniques des Essentiels de la recherche, mises à jour le 18 décembre 2025Google Search Central, documentation
- Googlebot, mis à jour le 3 février 2026 : la limite de 2 MoGoogle Search Central, documentation
- Présentation des robots de Google, mise à jour le 12 juin 2026 : la limite de 15 MoGoogle, documentation sur l’exploration
- Optimiser son budget d’exploration, mis à jour le 22 juillet 2026Google, documentation sur l’exploration
- Le rapport sur l’indexation des pagesAide de Search Console
- Le rapport Statistiques sur l’explorationAide de Search Console
- L’outil d’inspection de l’URLAide de Search Console
- Les bases du SEO pour JavaScript, mises à jour le 4 mars 2026Google Search Central, documentation
- L’indexation mobile d’abord, mise à jour le 10 décembre 2025Google Search Central, documentation
- La dernière étape de l’indexation mobile d’abord, 3 juin 2024Google Search Central, blog
- La canonicalisation, mise à jour le 20 août 2026Google Search Central, documentation
- Indiquer une URL canonique, mis à jour le 10 juillet 2026Google Search Central, documentation
- Créer et envoyer un sitemap, mis à jour le 8 juillet 2026Google Search Central, documentation
- Les codes de réponse HTTP et les erreurs réseau, mis à jour le 4 février 2026Google Search Central, documentation
- L’expérience sur la page, mise à jour le 22 septembre 2026Google Search Central, documentation
- Nouveau rapport HTTPS dans la Search Console, septembre 2022Google Search Central, blog
- Des liens que Google peut explorer, mis à jour le 10 décembre 2025Google Search Central, documentation
- Aider Google à comprendre la structure d’un site d’e-commerce, mis à jour le 10 décembre 2025Google Search Central, documentation
- Bloquer l’indexation avec noindex, mis à jour le 10 décembre 2025Google Search Central, documentation
- Les fonctionnalités d’IA et votre site, mises à jour le 10 décembre 2025Google Search Central, documentation
Sur le même sujet
 Référencement naturel
 Technique Lire la note Pages zombies en SEO : les repérer, et décider de leur sort Référencement naturel
 Pour agir Lire la note Core Web Vitals : LCP, INP, CLS, et ce que l’on corrige d’abord Référencement naturel Technique Lire la note